Errores del primer mes con el agente: diagnósticos que salvan la rutina
El primer mes con un agente tiene dos versiones: la del que lo abandona en la semana dos — porque el agente «no entiende nada» — y la del que en la semana cuatro tiene la rutina andando con un par de ajustes por semana. La diferencia entre ambas no es el modelo ni la herramienta: es cómo se diagnostican los errores de las primeras semanas, que son siempre los mismos — instrucciones que el agente ignora por partes, marcadores omitidos, ejecuciones que no corren, memoria que no aprende —. Este tutorial los recoge uno a uno con sus correcciones, siguiendo el capítulo 9 de ChatGPT Work 2027 y el capítulo de supervisión de Agentes IA para Profesionales 2027.
La regla que gobierna todos los diagnósticos del tutorial es de fondo: casi nunca el fallo está en la herramienta; está en las dos cosas que escribes tú — la instrucción y la plantilla — o en las dos cosas que no escribiste — la memoria y el registro. Con ese mapa, cada error del primer mes deja de ser un misterio y se convierte en una corrección con responsable claro.
Instrucciones que el agente ignora por partes
El síntoma es reconocible: la entrega respeta parte de lo pedido y se salta otra parte — el formato sí, la extensión no; las fuentes sí, el tono no —. El diagnóstico del método es directo: las instrucciones muy largas se procesan bien hasta cierto tamaño y, más allá, el modelo empieza a ignorar tramos; la regla práctica del capítulo es no alargar la instrucción que no se sigue, sino acortarla y hacerla más directa. Y si el detalle que se ignora es imprescindible — una regla legal, un formato —, el método da dos salidas: dividir el trabajo en dos agentes o mover el detalle a una instrucción reutilizable que se carga solo cuando la tarea lo necesita.
Cómo medir la instrucción: las 500 palabras del ejemplo
La guía de tamaño del método es de sentido común calibrado: una instrucción de quinientas palabras que el agente sigue siempre vale más que una de tres mil que ignora — y el límite práctico del capítulo está en torno a las ochocientas, con advertencia de que más allá del millar el modelo empieza a saltearse partes. El mismo principio se aplica a los modelos locales del capítulo de autoalojamiento — instrucciones de cien palabras con formato claro ganan a prompts de quinientas —, y en nube se nota igual: la instrucción corta y directa con su ejemplo de salida integrado vence a la instrucción enciclopédica con matices. Si tu instrucción vive en la carpeta instrucciones/ y crece cada semana, el arreglo del método es limpiarla — no es un archivo que solo crece, es un manual que se depura —.
Instrucción vs plantilla vs memoria: quién tiene la culpa
El método mapea cada tipo de error a su documento fuente de una forma que conviene memorizar: el formato que no se sigue es problema de plantilla — o de la referencia a la plantilla dentro de la instrucción —; los datos inventados son problema de restricción ausente — la regla del marcador que nunca se escribió —; el tono desviado es problema de memoria — correcciones de tono que nunca se anotaron —; y el agente que hace más o menos de lo pedido es problema de la sección «qué NO hace» de su ficha de puesto. Con ese mapa, el arreglo deja de ser tocar todo: tocas el documento correcto y el resto queda quieto. El error del primer mes más caro es el diagnóstico equivocado — corregir siete documentos para arreglar uno —.
El modelo cambió y el agente «se dañó»
El caso especial del primer trimestre es el desvío repentino: el agente funcionaba y, sin que tocarses nada, empieza a fallar. El método lo anticipa: los modelos subyacentes se actualizan sin previo aviso, y una instrucción que funcionaba puede dejar de funcionar tras una actualización. El diagnóstico es por comparación: ejecuta la tarea manualmente, compara el resultado con la entrega esperada, y según la diferencia, ajusta la instrucción — los modelos nuevos a veces piden instrucciones más directas, no más largas —. Si usas APIs, la versión del modelo se puede fijar en la configuración; si usas la interfaz, revisa qué cambió y ajusta contra el nuevo comportamiento. Y anótalo en memoria: los desvíos de actualización son el tipo de corrección que se repite cada pocos meses, y tener el caso escrito en la carpeta ahorra la re-conclusión.
El ejemplo de salida que falta: el formato que varía
Cuando el contenido de la entrega es correcto pero el formato varía cada vez — hoy cinco puntos, ayer siete —, la causa que el método describe no es una instrucción vaga sino la pieza que falta: el ejemplo de salida dentro de la instrucción — los agentes imitan ejemplos mejor que siguen descripciones —, y una descripción abstracta se presta a interpretación. La receta del método es copiar dentro de la instrucción una entrega entera tal como debió salir — el modelo de salida literal —, y la variación entre entregas baja de forma visible a partir de la siguiente ejecución. En el mapa de diagnóstico del tutorial, este caso es el hermano menor de la instrucción larga: el formato desviado se arregla en la ficha de puesto — con el ejemplo integrado —, y no reescribiendo el cuerpo de las entregas cada semana. La instrucción que lleva su ejemplo es la cerradura doble del formato: la plantilla define las secciones, el ejemplo fija el llenado.
Las instrucciones que crecen y las que se depuran
Un detalle del primer mes que el tutorial de plantillas deja entre líneas y aquí conviene explicitar: la instrucción no es un archivo que solo crece. Cada corrección recurrente que se integra en la instrucción debe permitir depurarla — quitar de la instrucción lo que la memoria ya recoge con más detalle, recortar las reglas duplicadas, reescribir las líneas que se saltan —, y el método lo formula en su regla editorial del manual del empleado: la instrucción que se depura es la que se sigue; la que se acumula es la que se ignora por tramos. La práctica de fin de mes del método — limpiar memoria, consolidar en instrucciones — tiene esta mitad: lo que se consolida, se recorta. El primer mes es el de las correcciones abundantes — quince en la primera semana —, y su destino no es una instrucción de tres páginas: es la instrucción de ochocientas palabras — con su ejemplo de salida —, que en el segundo mes se cumple por entero.
El dato que estaba fuera de contexto
Hay un caso de dato erróneo que la corrección del redondeo no cubre: la entrega trae una cifra correcta de una fuente fiable — y la extrajo mal: es de otro párrafo de la fuente, o fuera de la frase en la que se decía. El método del buscador del otro libro describe el caso y su receta: la respuesta que contradice lo que sabes no se descarta ni se acepta — se va a la fuente: abrir la cita, leer el pasaje del que se extrajo el dato y decidir delante del original. En las entregas de datos propios, la versión del caso es la fila citada del error: la fila es la correcta y la cifra es la de otra celda — la verificación del pasaje original es la misma: abrir la hoja, leer la celda, comparar. La regla de alcance del método también: la verificación del pasaje se hace en lo crítico — lo que alimenta decisiones —, no en todo el informe; y la revisión del cierre de la jornada, con su muestreo, es la que lo aplica con equilibrio.
Marcadores omitidos y datos que se rellenan solos
El segundo bloque de errores del primer mes es el del contenido: datos redondeados, cifras inventadas, huecos rellenados con plausibilidad. El tutorial los junta porque comparten el mismo origen: una restricción que no se escribió o una fuente que no se citó.
La cifra redondeada y la fila exacta
El caso más común con datos propios: la entrega trae una cifra plausible que no está en la fila de la hoja — el modelo redondeó o aproximó sin avisar —. La instrucción del método del capítulo de análisis es exacta: cita la fila o columna de donde extraes cada cifra, y no redondees — usa el valor exacto —. Y la revisión del caso no se queda en la corrección: la regla del analista es que cuando una cifra te sorprenda, se verifica en el original antes de que el informe salga. El dato que alimentará una decisión no sale a una reunión con «parece que era parecido» — sale con su fila y su valor literal.
El marcador omitido: [SIN DATOS] que desaparece
El segundo caso es el del hueco que se omitió en lugar de marcarse: la plantilla pedía una sección, la sección no tenía datos, y el agente entregó el documento sin ella — y sin aviso. La instrucción del método lo previene con una línea: si una sección no tiene datos, escribe [SIN DATOS] pero no la omitas — y así la estructura llega completa y los huecos se ven. El caso inverso — el agente que inventa el contenido de la sección en lugar de marcarla — comparte la misma solución con una segunda línea: si no tienes un dato, escribe [DATO PENDIENTE]. No inventes. Y la verificación del marcador pasa a la revisión de cada entrega: si una instrucción de marcador no se cumple, es de la misma familia del primer bloque — la regla existía pero vivía enterrada en una instrucción demasiado larga, y el arreglo es subirla de posiciones y hacerla inequívoca.
Errores sistemáticos: cuando falla siempre lo mismo
Hay una variante de error que la memoria corrige con ejemplos: el agente comete siempre el mismo desliz de clasificación o de formato en un caso concreto. El método del capítulo de autoalojamiento lo resuelve sin tocar la configuración: añade ejemplos corregidos a la carpeta de memoria — los modelos responden al contexto que les das, y unos pocos ejemplos bien clasificados suelen corregir el error sistemático. En la nube es igual: si el error sistemático vive en un caso recurrente — el mismo tipo de documento, el mismo tipo de correo —, los ejemplos corregidos en memoria son el arreglo, y la instrucción se actualiza solo si el caso tiene una regla que formular. El test de la corrección está en las ejecuciones de la semana siguiente: si el error repetía y deja de repetir, la memoria cumplió.
Ejecuciones que no corren y avisos que no llegan
El tercer bloque del primer mes es el de las tareas programadas: la ejecución se corre pero el entregable no aparece, o el aviso no llega, o la tarea desaparece del horario. El método da la receta por pasos: revisar el registro de la ejecución — casi siempre es un campo que cambió de nombre o un token que caducó —; si el aviso es lo que falla, verificar el canal de la alerta y darle una comprobación manual periódica — porque un aviso roto es un sistema ciego —. Y el caso límite del método es el del sistema que funciona y va más lento: suele ser el exceso de memoria — correcciones antiguas ya integradas que se archivan — y documentos de referencia que dejaron de ser relevantes. El mantenimiento del método — limpiar memoria, archivar lo obsoleto — es la rutina del cierre del mes, y el registro del día es el que dice si llegó el momento.
Los fallos silenciosos que el registro del día detecta
La ejecución ausente
El fallo silencioso más traicionero del primer mes no es un error visible: es la ejecución que no corrió. Nada falló — simplemente no ejecutó —, la tarea quedó pendiente y la mañanana no trae su briefing, su informe o su clasificación. La detección es del registro del cierre: la lista del día muestra qué tareas corrieron y cuáles se esperaban — la ausencia es la línea que no es ni correcto ni incorrecto: es la línea que falta. El método le da nombre en su supervisión: la alerta avisa del fallo, y el registro del día es el que detecta la ejecución faltante — el caso más traicionero, porque no da señales. La prevención es doble: la revisión semanal del conjunto de tareas programadas — cada una ejecutó lo esperado —, y el aviso de no ejecución cuando la plataforma lo permite — el método describe la alerta como mensaje del sistema cuando un flujo falla, y la pauta del plan de 21 días es revisar las ejecuciones de las primeras semanas una a una.
El campo que cambió de nombre
El segundo fallo silencioso es el del flujo que corre su ciclo — con resultado aparentemente normal — y no hace nada: la acción final no se ejecutó porque el campo que mapeaba cambió de nombre en la API de origen. El método lo describe en su solución de problemas con precisión: revisar el registro de la ejecución del flujo — casi siempre es un campo renombrado o un token caducado —, ajustar el mapeo y reejecutar. El síntoma es característico: el flujo corre, el entregable no aparece, y la ejecución no da error visible — porque el cambio del campo es legal desde el punto de vista del sistema. La prevención del método es la de la revisión periódica de las ejecuciones — el registro del día — y la de la anotación en memoria del caso, que para la próxima reorganización del proveedor ya tiene receta.
La alerta rota
El tercer fallo silencioso es el del aviso que ya no llega — y su peligro es doble: sin aviso, los fallos vuelven al silencio; y el sistema de aviso roto da la sensación de vigilancia que no existe. El método lo describe con su verificación propia: la alerta debe tener una comprobación periódica de funcionamiento — prueba manual del canal de aviso una vez al mes —, y su instrucción es que el propio flujo de alerta tenga tratamiento de errores — si el flujo principal falla y el de aviso también, no te enteras de nada. En el cierre de la jornada, esta pieza es de un minuto: si no llegó ningún aviso esta semana, confirmaste esta tarde que el canal funciona — la prueba manual del método es la que cierra la duda. Y la anotación en memoria del caso del aviso roto — qué día se detectó, qué cambió en el canal — es la que convierte una incidencia en una rutina de mantenimiento.
Qué has construido y qué sigue construyéndose
El checklist del método
El método lista lo construido con la pieza del diagnóstico montada: el archivo de correcciones con las entradas de las primeras tareas, subido al espacio de trabajo del agente; el protocolo de revisión semanal establecido — el viernes, en su cita — y una tendencia medible: menos errores por semana. El tutorial añade el mapa de familias: cada tipo de fallo con su documento responsable — formato a plantilla, contenido a restricción, tono a memoria, alcance a la ficha de puesto — y la comparación controlada como diagnóstico cuando el mapa no basta. Con el mapa, el primer mes deja de ser una prueba de paciência: es la escuela del sistema.
Qué sigue: de corregir a escalar
La señal del método para pasar de corregir a escalar es la de la curva: cuando las correcciones de la semana son uno o dos y son de ajuste fino, el sistema está listo para el siguiente puesto — la segunda tarea delegable, montada con las lecciones del primero, como pide el plan del libro en su semana dos. Y si la curva no baja, el orden del tutorial es el de su diagnóstico: la instrucción se depura antes de añadir nada — la regla del método de escalado es de prudencia: cada agente nuevo necesita su período de correcciones, y ninguno merece entrar a medio calibrar el anterior. La curva es la que decide, y el registro es el que la muestra — así de simple y así de mecánico: el método premia al que anota, y el que anota puede escalar.
Para ver el método completo desde el lado del profesional, hay un artículo de MargaPress sobre el empleado digital como colaborador, y en MargaBooks, la página del libro ChatGPT Work 2027. Ningún enlace sustituye la prueba: el diagnóstico del primer mes es el que separa la rutina que se abandona de la que en la semana cuatro ya trabaja sola.
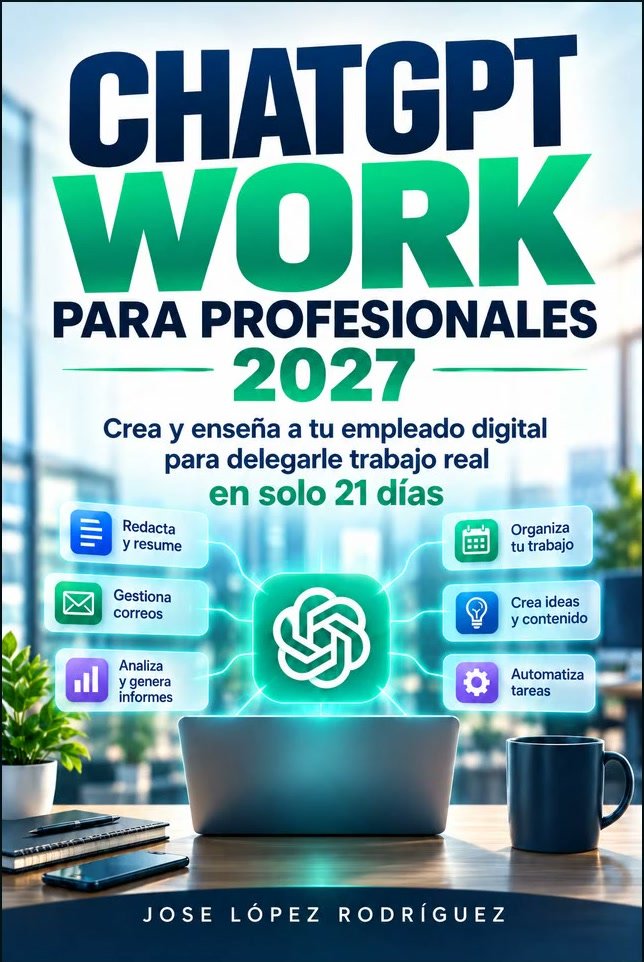
ChatGPT Work 2027
Instrucciones cortas, memoria de correcciones y registro de ejecución: el manual completo para que tu agente pase el primer mes.
Consulta la ficha del libro para conocer disponibilidad y condiciones actuales.